Hoe kan je jouw eigen AI-model trainen of fine-tunen voor specifieke toepassingen?
Het ontwikkelen van een AI-model lijkt misschien iets voor techgiganten zoals Google of OpenAI, maar ook bedrijven en individuen kunnen hun eigen AI-modellen trainen. Het gaat niet alleen om technische kennis, maar vooral om begrijpen wat je wilt bereiken en hoe je data kunt omzetten in waardevolle inzichten. Of het nu gaat om gepersonaliseerde aanbevelingen voor klanten, het automatisch herkennen van afwijkingen in productiekwaliteit, of het voorspellen van klantbehoeften, een goed getraind AI-model kan jouw bedrijf transformeren.
Wat betekent het om een AI-model te trainen?
Een AI-model trainen betekent dat je een systeem leert om patronen te herkennen in data. Dit kan variëren van simpele taken, zoals het herkennen van tekst of afbeeldingen, tot complexe voorspellingen op basis van grote datasets. In feite leer je het model om zelf beslissingen te nemen op basis van wat het heeft geleerd.
Maar hier begint ook het eerste risico. Een slecht getraind model kan verkeerde conclusies trekken. Een AI-systeem dat klanten moet helpen, maar verkeerd is getraind, kan klanten frustreren in plaats van helpen. Een model dat fraude moet detecteren, maar vooroordelen in de data heeft, kan onschuldige klanten onterecht verdenken.
Hoe begin je met trainen van je eigen AI-model?
De eerste stap is duidelijkheid over het doel. Wat wil je dat je model doet? Dit lijkt misschien vanzelfsprekend, maar zonder een scherp gedefinieerd doel loop je het risico tijd en geld te verspillen. Stel jezelf vragen zoals:
Wil ik klantgedrag voorspellen?
Moet mijn model objecten herkennen in afbeeldingen?
Wil ik automatisch teksten analyseren en samenvatten?
Vervolgens heb je data nodig. Data is de brandstof voor elk AI-model. Dit kunnen klantgegevens zijn, afbeeldingen, tekst of andere vormen van informatie. Maar niet alle data is bruikbaar. Als je model klanten moet herkennen, heeft het geen zin om data te gebruiken over productieverkoop.
Zorg voor schone, representatieve data
Veel AI-projecten mislukken omdat de data slecht is. Denk aan incomplete gegevens, verkeerde labels of eenzijdige informatie. Een model dat wordt getraind op eenzijdige data, leert verkeerde patronen. Dit kan leiden tot fouten, discriminatie of zelfs gevaarlijke beslissingen.
In de praktijk betekent dit dat je data moet verzamelen, opschonen en controleren. Een bedrijf dat een AI-model wil ontwikkelen om sollicitanten te beoordelen, moet zorgen dat de data representatief is voor alle demografische groepen. Anders loopt het risico kandidaten te discrimineren.
Het trainen van je model: stap voor stap
Data voorbereiden: Verzamel je data en zorg dat deze schoon en gestructureerd is. Gebruik tools zoals Python, Jupyter Notebooks of gespecialiseerde platforms zoals Google Colab.
Het model kiezen: Bepaal welk type model het beste past bij je doel. Voor tekstanalyse kun je werken met taalmodellen zoals BERT of GPT. Voor beeldherkenning zijn Convolutional Neural Networks (CNN’s) populair.
De training starten: Gebruik een AI-bibliotheek zoals TensorFlow of PyTorch om je model te trainen. Dit is waar het model de patronen in de data leert herkennen.
Fine-tuning: Pas je model aan voor je specifieke toepassing. Dit kan betekenen dat je het model opnieuw traint op jouw data, of dat je extra lagen toevoegt aan het netwerk om het nauwkeuriger te maken.
Valideren en testen: Controleer of je model goed presteert. Test het op nieuwe data die het nog niet heeft gezien. Krijgt het de juiste resultaten? Zijn er fouten?
Implementeren: Zodra je model goed werkt, kun je het inzetten in je applicatie of bedrijfsproces. Dit kan via een cloudplatform zoals AWS, Azure of lokaal op je eigen servers.
Het verschil tussen trainen en fine-tunen
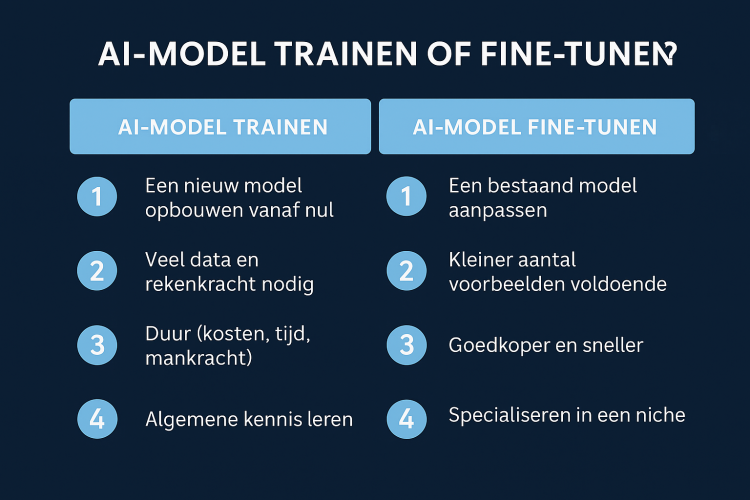
Het trainen van een AI-model betekent dat je vanaf nul begint. Je laat het systeem patronen ontdekken in de data zonder enige voorkennis. Fine-tunen betekent dat je een bestaand model gebruikt dat al getraind is, en dit verder aanpast voor jouw specifieke toepassing.
Stel dat je een AI wilt die gezichten herkent. Je kunt een bestaand model zoals VGG-Face gebruiken en dit verder trainen met foto’s van jouw medewerkers. Dit bespaart tijd en maakt het model vaak veel nauwkeuriger.
Fine-tuning is vooral handig voor kleinere bedrijven die geen miljoenen data-punten hebben, maar wel een specifiek doel willen bereiken. Het geeft je de kracht van geavanceerde AI zonder de tijd en kosten van volledig zelf trainen.
Risico’s van een slecht getraind model
Een AI-model dat verkeerd is getraind, kan meer schade aanrichten dan je denkt. Een model dat klantvragen automatisch beantwoordt, kan klanten irriteren met verkeerde of onbegrijpelijke antwoorden. Een fraudedetectiemodel kan onschuldige klanten onterecht markeren als risico.
Het is daarom essentieel om je model regelmatig te controleren en bij te werken. Technologie verandert snel, en wat vandaag werkt, kan morgen verouderd zijn. Een model dat gebaseerd is op verouderde data kan verkeerde beslissingen nemen.
AI die werkt voor jou, niet tegen je
Het succes van een AI-model hangt niet alleen af van technische perfectie, maar vooral van het begrijpen van de context waarin het wordt gebruikt. Bedrijven die AI gebruiken als ondersteuning van hun medewerkers, in plaats van als vervanging, halen de beste resultaten.
Wil je dat klanten automatisch worden geholpen, maar altijd een menselijke medewerker kunnen bereiken als het misgaat? Zorg dan dat je AI dat begrijpt. Wil je dat je model snel patronen in verkoopdata herkent? Zorg dat het flexibel blijft en leert van nieuwe data.
Een goed AI-model is als een slimme assistent. Het denkt met je mee, maar neemt niet zomaar de controle over.


